
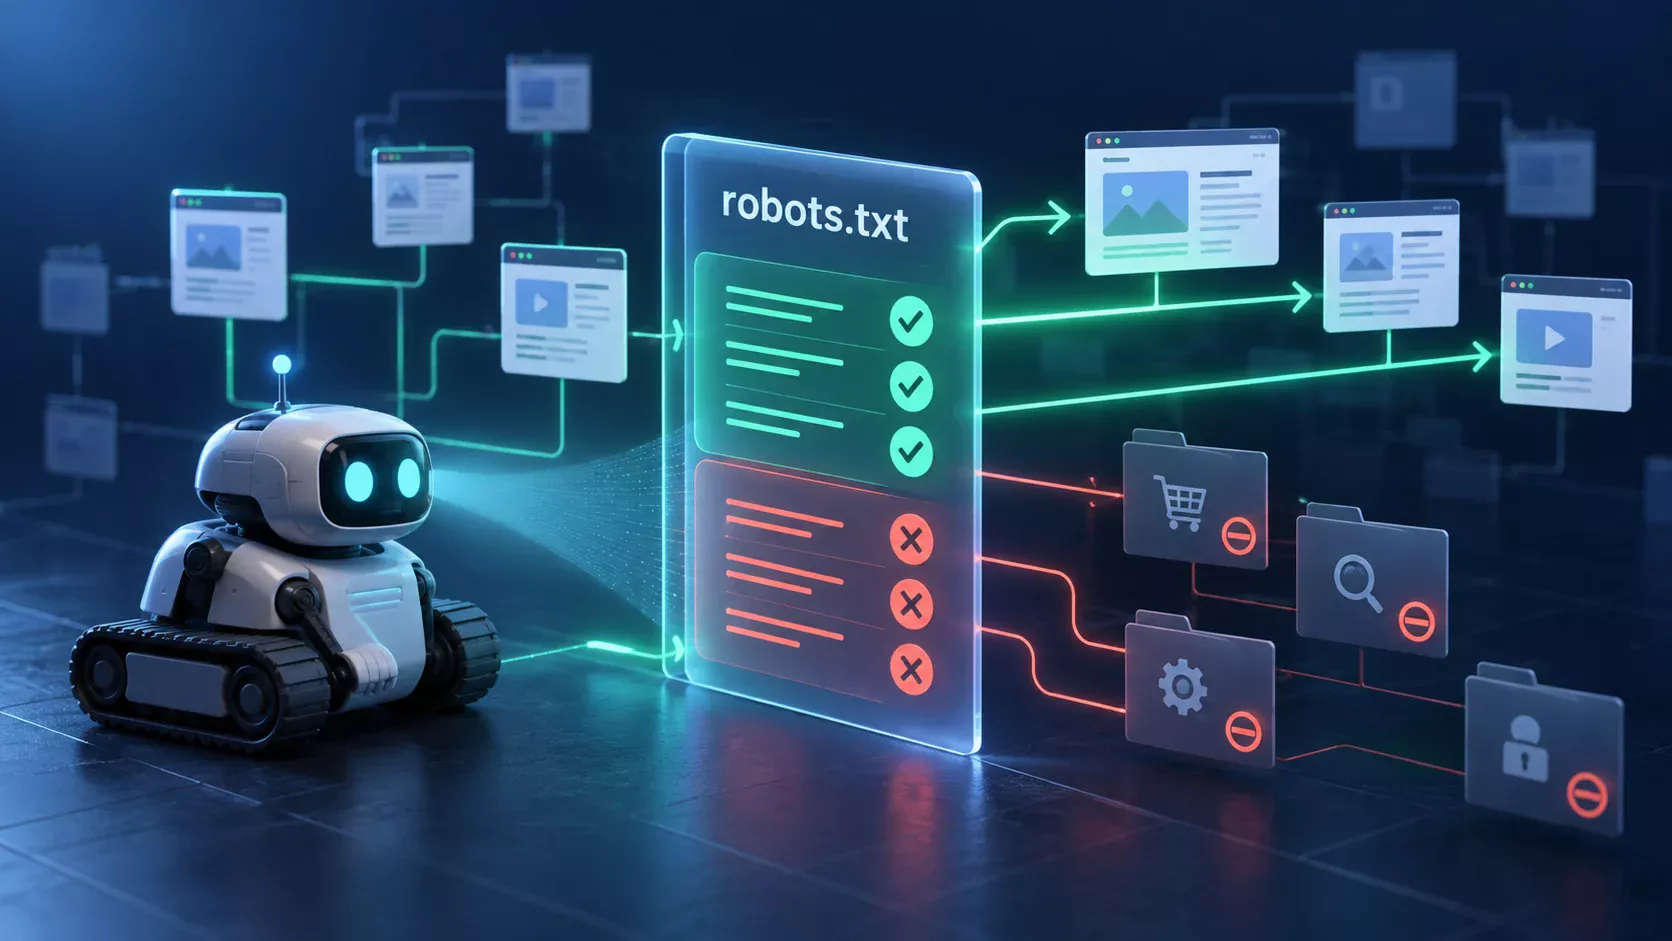
Що насправді робить robots.txt
robots.txt — звичайний текстовий файл у корені сайту. Пошуковий робот запитує його перед обходом сторінок і читає групу правил, що відповідає його імені. Головне завдання файлу — керувати скануванням: відкривати корисні розділи та не витрачати ресурси на URL, які не потрібно регулярно обходити.
Правильна адреса має вигляд https://example.com/robots.txt. Правила стосуються лише конкретної комбінації протоколу, хоста й порту. Файл на www.example.com не керує піддоменом shop.example.com, а /blog/robots.txt не замінює файл у корені.
Disallow забороняє роботу запитувати URL, але не є надійною командою «прибрати сторінку з пошуку». Якщо закритий URL відомий із зовнішніх або внутрішніх посилань, пошуковик може показати саму адресу без вмісту сторінки.Щоб прибрати HTML-сторінку з пошуку, зазвичай залишають її доступною для обходу й додають noindex у метатег або HTTP-заголовок. Конфіденційні дані захищають авторизацією. Видалені сторінки мають повертати 404 або 410. Кожен інструмент виконує окреме завдання.
Синтаксис: п’ять директив, які потрібно розуміти
| Директива | Що означає | Приклад |
|---|---|---|
User-agent | Визначає робота, для якого створено групу правил. Зірочка означає всіх роботів. | User-agent: * |
Disallow | Забороняє сканування зазначеного шляху. | Disallow: /cart/ |
Allow | Відкриває конкретніший шлях усередині закритого розділу. | Allow: /catalog/public/ |
Sitemap | Зазначає абсолютну адресу XML-карти сайту. | Sitemap: https://example.com/sitemap.xml |
# | Починає коментар для людини й не вважається правилом. | # Кошик і оформлення |
Мінімальний безпечний файл
Якщо весь публічний сайт можна обходити, складна конфігурація не потрібна. Достатньо загальної групи та посилання на карту сайту:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Порожній Disallow означає відсутність заборони. Натомість Disallow: / закриває від сканування весь хост. Плутанина між цими варіантами часто знищує органічний трафік після перенесення конфігурації зі staging на робочий домен.
Як вибирається правило
Для одного робота порівнюються відповідні правила Allow і Disallow. Перевагу отримує найконкретніший шлях. Тому всередині закритого каталогу можна відкрити окрему папку або файл:
User-agent: *
Disallow: /private/
Allow: /private/public-guide.pdf
Шляхи можуть бути чутливими до регістру, тому /Catalog/ і /catalog/ іноді є різними адресами. Символ * замінює послідовність символів, а $ фіксує кінець URL. Використовуйте шаблони лише після перевірки на реальних адресах.
# Закриваємо PDF, але не HTML-сторінки
User-agent: Googlebot
Disallow: /*.pdf$
Безпечні шаблони для різних типів сайтів
Не переносіть жоден шаблон без перевірки. Спочатку випишіть реальні URL сайту, визначте призначення кожного розділу та вирішіть, які сторінки мають брати участь у пошуку.
Корпоративний сайт
User-agent: *
Disallow: /admin/
Disallow: /search/
Disallow: /thank-you/
Disallow: /api/

Sitemap: https://example.com/sitemap.xml
У цьому прикладі закрито панель керування, внутрішній пошук, технічну сторінку подяки та API. Сторінки послуг, блог, зображення, CSS і JavaScript залишаються доступними.
WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://example.com/wp-sitemap.xml
Для WordPress зазвичай достатньо закрити адміністративний розділ, відкрити admin-ajax.php і обмежити результати внутрішнього пошуку. Не закривайте весь /wp-content/: там містяться зображення, стилі та скрипти, потрібні для правильного відтворення сторінок.
Інтернет-магазин із фільтрами
User-agent: *
Disallow: /cart/
Disallow: /checkout/
Disallow: /account/
Disallow: /compare/
Disallow: /wishlist/
Disallow: /*?sort=
Disallow: /*?view=
Disallow: /*?page_size=

Sitemap: https://shop.example.com/sitemap.xml
Кошик, оформлення, особистий кабінет і технічні параметри сортування зазвичай не потрібні в пошуку. Фасетні фільтри потребують окремої стратегії: деякі комбінації можуть бути повноцінними посадковими сторінками з реальним попитом.
Окремі правила для конкретного робота
Якщо одному роботу потрібні особливі правила, створіть окрему групу. Не розраховуйте, що вона автоматично успадкує загальну групу: робот вибирає найвідповіднішу групу правил.
User-agent: Googlebot
Disallow: /temporary-for-google/

User-agent: *
Disallow: /private-for-all/

Sitemap: https://example.com/sitemap.xml
Директива Crawl-delay трапляється у старих прикладах, але Googlebot її не підтримує. Якщо сервер перевантажено, потрібно виправляти продуктивність і причини нескінченного обходу, а не покладатися на непідтримувану директиву.
robots.txt, noindex, canonical і sitemap — різні інструменти
| Інструмент | Завдання | Коли використовувати |
|---|---|---|
robots.txt | Керує скануванням URL. | Кошик, внутрішній пошук, нескінченні параметри та службові розділи. |
noindex | Забороняє показувати доступну сторінку в результатах пошуку. | Сторінка потрібна користувачеві, але не має індексуватися. |
canonical | Вказує пріоритетну версію серед дублів. | Однаковий або дуже схожий контент доступний за кількома адресами. |
sitemap.xml | Передає перелік пріоритетних канонічних сторінок. | Допомагає виявленню сторінок і контролю структури. |
| Пароль або авторизація | Справді обмежує доступ до даних. | Особисті кабінети, внутрішні документи, staging і конфіденційні файли. |
Найнебезпечніша комбінація — одночасно закрити сторінку в robots.txt і додати до неї noindex. Робот не зможе відкрити сторінку та прочитати заборону індексації. Спочатку дозвольте обхід і дочекайтеся обробки noindex, а потім вирішуйте, чи потрібне блокування сканування.
robots.txt також не виправляє дублікати. Якщо кілька URL мають об’єднати сигнали в одну сторінку, використовуйте правильний редирект або канонічний URL, а не приховуйте проблему від роботів.
Типові помилки, через які сайт втрачає видимість
| Помилка | Що відбувається | Як виправити |
|---|---|---|
Disallow: / на робочому сайті | Усі сторінки закриті від сканування. | Прибрати загальну заборону й перевірити файл після публікації. |
| Закриті CSS і JavaScript | Робот бачить сторінку без правильного дизайну та функцій. | Відкрити ресурси, потрібні для відтворення основного контенту. |
| robots.txt використовують як захист | Секретні шляхи стають публічно переліченими. | Використовувати пароль, авторизацію та серверні обмеження. |
Закривають сторінку з noindex | Робот не може прочитати метатег і прибрати URL з індексу. | Дозволити сканування до обробки noindex. |
| Копіюють правила іншої CMS | Корисні каталоги й посадкові сторінки випадково потрапляють під заборону. | Будувати правила за власними URL і логікою сайту. |
| Блокують усі параметри | Можна втратити корисні фільтри або мовні версії. | Відокремити зайві параметри від повноцінних посадкових сторінок. |
| Зазначають відносний Sitemap | Роботи можуть непередбачувано обробити адресу. | Використовувати повний URL із протоколом і доменом. |
| Перевіряють лише головну | Помилки залишаються в категоріях і шаблонах. | Тестувати набір URL кожного типу. |
Як перевірити robots.txt перед публікацією
- Відкрийте файл у браузері. Адреса
/robots.txtмає повертати200і показувати звичайний текст, а не HTML-шаблон, переадресацію на вхід чи помилку сервера. - Підготуйте контрольні URL. Візьміть головну, послугу, статтю, категорію, товар, фільтр, пошук, кошик, кабінет і тестову технічну адресу.
- Зіставте кожен URL із правилом. Не оцінюйте файл лише візуально: визначте, яке конкретне правило спрацює для кожної адреси.
- Перевірте важливі сторінки в Search Console. Інструмент перевірки URL покаже, чи може Google отримати доступ і сканувати сторінку.
- Перевірте sitemap. XML-карта має містити лише канонічні сторінки з кодом
200, які не заборонені та не маютьnoindex. - Повторіть перевірку після релізу. Плагіни CMS, CDN або хостинг можуть змінювати robots.txt поза вихідним кодом.
Disallow: /.Безпечна схема налаштування robots.txt
Починайте не з директив, а з карти URL. Розділіть адреси на три групи: сторінки, які мають ранжуватися; технічні URL, потрібні користувачам; зайві або нескінченні комбінації. Для кожної групи виберіть відповідний інструмент.
- Вивантажте всі типи URL із CMS, sitemap і краулера.
- Позначте сторінки, що приносять трафік, посилання або конверсії.
- Перевірте параметри, фільтри, внутрішній пошук, сортування й архіви дат.
- Спочатку виправте статуси, редиректи, canonical і noindex.
- Лише після цього обмежуйте справді непотрібне сканування.
- Збережіть попередню версію файлу та дату зміни.
- Через кілька днів перевірте Search Console і серверні логи.
На невеликому корпоративному сайті robots.txt зазвичай залишається коротким. Великий файл із десятками шаблонів часто означає, що структура URL і CMS потребують окремого технічного SEO-аудиту.
Запитання та відповіді
Чи потрібен robots.txt кожному сайту?
Ні. Якщо роботам можна обходити весь сайт, файл може бути порожнім або відсутнім. На практиці його часто створюють для явного посилання на sitemap і фіксації технічних розділів.
Чи можна прибрати сторінку з Google через robots.txt?
Надійно — ні. Disallow обмежує сканування, але URL може залишитися в пошуку, якщо на нього ведуть посилання. Використовуйте noindex за дозволеного обходу або обмежуйте доступ авторизацією.
Чи потрібно закривати CSS і JavaScript?
Зазвичай ні. Пошуковику потрібні стилі та скрипти, щоб побачити сторінку приблизно так само, як користувач. Блокуйте лише ресурси, які не впливають на корисний контент.
Чи підтримує Google директиву Crawl-delay?
Googlebot не використовує Crawl-delay з robots.txt. Потрібно виправляти продуктивність сервера й нескінченні простори URL.
Де має знаходитися robots.txt?
У корені хоста: https://example.com/robots.txt. Для кожного піддомену й протоколу діють власні правила.
Джерела
Матеріал підготовлено на основі офіційної документації Google Search Central і стандарту Robots Exclusion Protocol: