
Что на самом деле делает robots.txt
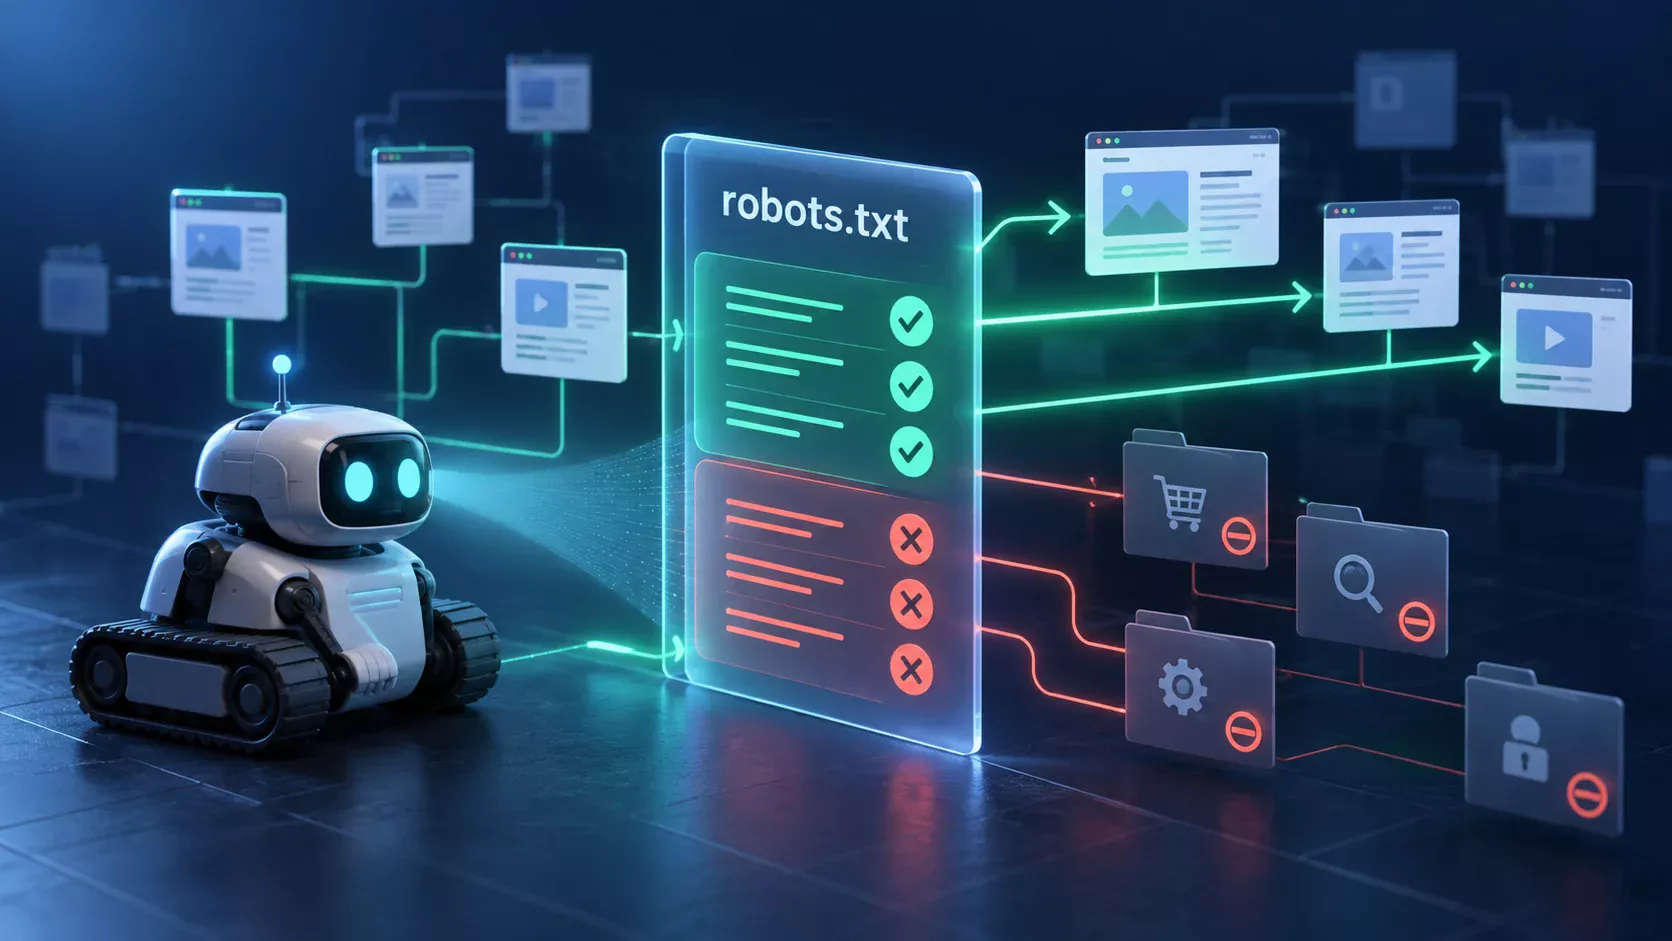
robots.txt — обычный текстовый файл в корне сайта. Поисковый робот запрашивает его до обхода страниц и читает правила, относящиеся к своему имени. Главная задача файла — управлять сканированием: открыть нужные разделы и не тратить ресурсы на URL, которые не должны регулярно обходиться.
Правильный адрес выглядит так: https://example.com/robots.txt. Правила относятся только к конкретной комбинации протокола, домена и порта. Файл на www.example.com не управляет поддоменом shop.example.com, а файл в каталоге /blog/robots.txt не заменяет корневой.
Disallow запрещает роботу запрашивать URL, но не является надёжной командой «убрать страницу из поиска». Если закрытый URL известен по внешним или внутренним ссылкам, поисковик может показать сам адрес без содержимого страницы.
Чтобы исключить HTML-страницу из поиска, обычно оставляют её доступной для обхода и добавляют noindex в метатег или HTTP-заголовок. Конфиденциальные данные защищают авторизацией. Удалённые страницы возвращают корректный код 404 или 410. У каждого инструмента своя задача.
Синтаксис: пять директив, которые нужно понимать
| Директива | Что означает | Пример |
|---|---|---|
User-agent | Определяет робота, для которого написана группа правил. Звёздочка означает всех. | User-agent: * |
Disallow | Запрещает сканирование указанного пути. | Disallow: /cart/ |
Allow | Открывает более конкретный путь внутри закрытого раздела. | Allow: /catalog/public/ |
Sitemap | Указывает абсолютный URL XML-карты сайта. | Sitemap: https://example.com/sitemap.xml |
# | Начинает комментарий для человека и не считается правилом. | # Корзина и оформление |
Минимальный безопасный файл
Если весь публичный сайт можно обходить, сложная конфигурация не нужна. Достаточно общей группы и ссылки на карту сайта:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Пустой Disallow означает, что запрета нет. Строка Disallow: /, напротив, закрывает от сканирования весь хост. Именно путаница между этими двумя вариантами часто уничтожает органический трафик после переноса со staging на рабочий домен.
Как выбирается правило
Для одного робота сравниваются подходящие правила Allow и Disallow. Приоритет получает наиболее конкретный путь. Поэтому внутри закрытого каталога можно открыть отдельную папку или файл:
User-agent: *
Disallow: /private/
Allow: /private/public-guide.pdf
Пути чувствительны к регистру на серверах, где /Catalog/ и /catalog/ — разные адреса. Символ * заменяет последовательность символов, а $ фиксирует конец URL. Такие шаблоны полезны, но их стоит применять только после проверки на реальных адресах.
# Закрываем PDF с любым путём, но не HTML-страницы
User-agent: Googlebot
Disallow: /*.pdf$
Готовые шаблоны для разных типов сайтов
Ни один шаблон нельзя переносить вслепую. Сначала выпишите реальные URL сайта, определите назначение каждого раздела и проверьте, какие страницы должны участвовать в поиске.
Обычный корпоративный сайт
User-agent: *
Disallow: /admin/
Disallow: /search/
Disallow: /thank-you/
Disallow: /api/

Sitemap: https://example.com/sitemap.xml
Здесь закрыты панель управления, внутренний поиск, техническая страница благодарности и API. Страницы услуг, блог, изображения, CSS и JavaScript остаются доступными.
WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://example.com/wp-sitemap.xml
Для WordPress обычно достаточно закрыть административный раздел, открыть служебный admin-ajax.php и ограничить результаты внутреннего поиска. Не закрывайте /wp-content/ целиком: там находятся изображения, стили и скрипты, необходимые для корректного рендеринга страниц.
Интернет-магазин с фильтрами
User-agent: *
Disallow: /cart/
Disallow: /checkout/
Disallow: /account/
Disallow: /compare/
Disallow: /wishlist/
Disallow: /*?sort=
Disallow: /*?view=
Disallow: /*?page_size=

Sitemap: https://shop.example.com/sitemap.xml
Корзина, оформление, личный кабинет и технические параметры сортировки обычно не нужны в поиске. Но фасетные фильтры нельзя закрывать одним универсальным списком: часть комбинаций может быть полноценными посадочными страницами с реальным спросом.
Отдельные правила для конкретного робота
Если группе конкретного робота нужны особые правила, создайте отдельный блок. Не рассчитывайте, что он автоматически «добавится» к общей группе: робот выбирает наиболее подходящую группу правил.
User-agent: Googlebot
Disallow: /temporary-for-google/

User-agent: *
Disallow: /private-for-all/

Sitemap: https://example.com/sitemap.xml
Директива Crawl-delay встречается в старых примерах, но Googlebot её не поддерживает. Если сервер перегружен, нужно исправлять производительность и причины бесконечного обхода, а не добавлять неподдерживаемую строку.
robots.txt, noindex, canonical и sitemap — не одно и то же
| Инструмент | Задача | Когда использовать |
|---|---|---|
robots.txt | Управляет сканированием URL. | Корзина, поиск, бесконечные параметры, служебные разделы. |
noindex | Запрещает показывать доступную страницу в результатах поиска. | Страница нужна пользователю, но не должна индексироваться. |
canonical | Подсказывает предпочтительную версию среди дублей. | Одинаковый или очень похожий контент доступен по нескольким URL. |
sitemap.xml | Передаёт список приоритетных канонических страниц. | Для ускорения обнаружения и контроля структуры сайта. |
| Пароль или авторизация | Реально ограничивает доступ к данным. | Личный кабинет, внутренние документы, staging и конфиденциальные файлы. |
Самая опасная комбинация — одновременно закрыть страницу в robots.txt и поставить на неё noindex. Робот не сможет открыть страницу и прочитать запрет на индексацию. Сначала нужно разрешить обход, дождаться обработки noindex, а уже потом решать, нужен ли запрет сканирования.
Точно так же robots.txt не исправляет дубли. Если несколько URL должны объединить сигналы в одну страницу, используйте корректный редирект или канонический URL, а не маскируйте проблему запретом обхода.
Типичные ошибки, из-за которых сайт теряет видимость
| Ошибка | Что происходит | Как исправить |
|---|---|---|
Disallow: / на рабочем сайте | Все страницы закрыты от сканирования. | Удалить общий запрет и проверить файл после переноса со staging. |
| Закрыты CSS и JavaScript | Робот видит страницу без нормального дизайна и функциональности. | Открыть ресурсы, нужные для рендеринга основного контента. |
| robots.txt используют как защиту | Секретные пути становятся публично перечисленными. | Использовать пароль, авторизацию и серверные ограничения. |
Закрывают страницу с noindex | Робот не может прочитать метатег и удалить URL из индекса. | Разрешить сканирование до обработки noindex. |
| Копируют правила чужой CMS | Полезные каталоги и посадочные случайно попадают под запрет. | Строить правила по реальным URL и логике своего сайта. |
| Блокируют все параметры | Теряются полезные фильтры или языковые версии. | Разделить мусорные параметры и полноценные посадочные страницы. |
| Указывают относительный Sitemap | Роботы могут обработать адрес непредсказуемо. | Указывать полный URL с протоколом и доменом. |
| Проверяют только главную | Ошибка остаётся в важных категориях или служебных шаблонах. | Тестировать набор URL каждого типа. |
Как проверить robots.txt перед публикацией
- Откройте файл в браузере. Адрес
/robots.txtдолжен отвечать кодом200и показывать обычный текст без HTML-шаблона, редиректа на вход или ошибки сервера. - Соберите контрольные URL. Возьмите главную, услугу, статью, категорию, карточку товара, фильтр, поиск, корзину, кабинет и тестовый служебный адрес.
- Сопоставьте каждый URL с правилом. Не оценивайте файл «на глаз»: проверьте, какое конкретное правило сработает для каждой страницы.
- Проверьте важные страницы через Search Console. Инструмент проверки URL покажет, доступен ли адрес Google и разрешено ли его сканирование.
- Проверьте sitemap. В XML-карте должны быть только канонические страницы с кодом
200, которые не запрещены в robots.txt и не имеютnoindex. - Повторите проверку после релиза. robots.txt часто меняется не в исходниках, а на уровне CMS, CDN, плагина или окружения хостинга.
Disallow: /.
Рабочая схема настройки без риска
Начинайте не с директив, а с карты сайта. Разделите URL на три группы: страницы, которые должны ранжироваться; технические URL для пользователей; мусорные и бесконечные комбинации. Для каждой группы выберите подходящий инструмент.
- Выгрузите все типы URL из CMS, sitemap и краулера.
- Отметьте страницы, приносящие трафик, ссылки или конверсии.
- Проверьте параметры, фильтры, поиск, сортировки и календарные архивы.
- Сначала исправьте статусы, редиректы, canonical и noindex.
- Только после этого ограничивайте действительно ненужное сканирование.
- Сохраните предыдущую версию файла и дату изменения.
- Через несколько дней проверьте Search Console и серверные логи.
На небольшом корпоративном сайте robots.txt обычно остаётся коротким. Большой файл с десятками масок часто показывает, что структура URL и настройки CMS требуют отдельного технического SEO-аудита.
Вопросы и ответы
Нужен ли robots.txt каждому сайту?
Нет. Если поисковым роботам можно обходить весь сайт, файл может быть пустым или отсутствовать. На практике его часто создают хотя бы для явной ссылки на sitemap и фиксации служебных разделов.
Можно ли закрыть страницу от индексации через robots.txt?
Надёжно — нет. Disallow ограничивает сканирование, но URL может остаться в поиске, если на него ведут ссылки. Для исключения из поиска применяют noindex при разрешённом обходе или ограничивают доступ авторизацией.
Нужно ли закрывать CSS и JavaScript?
Обычно нет. Поисковику нужны стили и скрипты, чтобы увидеть страницу примерно так же, как пользователь. Блокировать можно только ресурсы, которые точно не участвуют в отображении полезного контента.
Поддерживает ли Google директиву Crawl-delay?
Googlebot не использует Crawl-delay из robots.txt. При перегрузке сервера нужно устранять технические причины и бесконечные пространства URL, а не полагаться на эту директиву.
Где должен находиться robots.txt?
В корне хоста: https://example.com/robots.txt. Для каждого поддомена и протокола действуют собственные правила.
Источники
При подготовке материала использованы официальная документация Google Search Central и стандарт Robots Exclusion Protocol: